아래는 출처에서 가져온 원문입니다.
구글이 자연어 프롬프트만으로 새로운 음성을 설계하고 대사별 연기와 억양까지 세밀하게 조절할 수 있는 텍스트 음성 변환(TTS) 모델 2종을 출시했다. 기존의 고정된 음성 선택 방식에서 벗어나 게임, 오디오북, 팟캐스트, 더빙, 음성 에이전트 등 다양한 분야에서 맞춤형 음성을 제작할 수 있도록 한 것이 특징이다.
구글은 23일(현지시간) 제미나이 오디오 제품군에 '제미나이 3.8 플래시 TTS'와 '제미나이 3.8 플래시-라이트 TTS'를 추가했다고 밝혔다.
플래시 TTS는 창작자와 개발자가 캐릭터 음성을 처음부터 설계하고 세밀하게 연출할 수 있도록 하는 데 초점을 맞췄으며, 플래시-라이트 TTS는 대규모 더빙이나 음성 콘텐츠 제작처럼 높은 처리량과 비용 효율성이 필요한 작업을 겨냥한다.
이번 모델의 핵심 경쟁력은 '음성을 고르는 것'에서 '음성을 디자인하는 시스템'으로의 패러다임 전환이다. 자연어 프롬프트 입력만으로 역할, 억양, 음색 등의 특징을 지닌 완전히 새로운 맞춤형 목소리를 즉석에서 생성할 수 있다.
두 모델 모두 100개 이상의 언어 및 방언을 자동 감지해 지원하며, 멕시코 스페인어, 퀘벡 프랑스어, 스코틀랜드 영어 등 미세한 지역별 억양도 구현한다. 또 즉시 서비스에 도입할 수 있는 2000개 이상의 상용급 기본 음성 라이브러리도 함께 제공된다. 앞으로는 기존 음성의 음색, 높낮이, 속도를 프롬프트로 재가공하는 '음성 리믹스' 기능도 선보일 예정이다.
또 30초 분량의 음성 샘플을 이용해 일관된 음성 프로필을 만드는 음성 복제 기능도 지원한다. 다만 본인이나 사용 권한을 보유한 음성만 복제할 수 있으며, 음성 소유자의 동의 녹음을 확인해야 한다. 복제 음성에는 C2PA 콘텐츠 인증 정보도 적용된다.
introducing Gemini 3.8 Flash TTS and Gemini 3.8 Flash-Lite TTS, our most expressive audio generation models yet
these models enable creators, developers, and enterprises to create richer, more expressive audio experiences
try them via the Gemini API and in AI Studio:… pic.twitter.com/vV84ErmKY1
— Google AI Studio (@GoogleAIStudio) September 23, 2026
두 모델 모두 대사별 연기 방식을 세밀하게 조절하는 강력한 연출 기능을 제어할 수 있다. 말하는 속도와 감정 변화는 물론 <웃음(laughs)> <한숨(sigh)> <헉(gasp)>과 같은 비언어적 음성 표현과 |음(mhm)| |응(yeah)| 등 자연스러운 맞장구와 추임새까지 스크립트에 포함해 연출할 수 있다.
특히 단일 스크립트 입력만으로 두 명의 화자가 주고받는 대화 장면을 자연스러운 턴테이킹(Turn-taking)과 함께 구현하는 '2인 대화 구성'이 가능하며, 장시간 오디오 생성 시에도 음질과 화자 특성을 안정적으로 유지하는 뛰어난 긴 길이 생성 안정성을 확보했다.
성능 면에서도 독보적인 오디오 품질을 입증했다. 자체 평가 결과 제미나이 3.8 플래시 TTS는 흄(Hume) AI의 '보이스 디자인 벤치마크(Voice Design Benchmark)'에서 71.4점으로 종합 1위를 기록했고, 억양 모델링에서도 60.8점으로 선두를 차지했다.
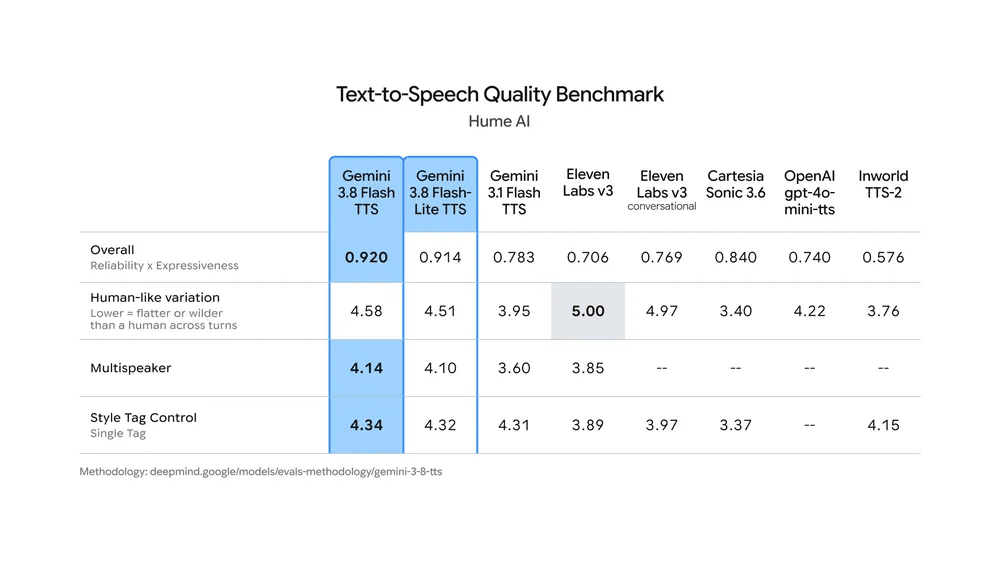
흄 AI '종합 품질 지수(Overall Quality Index)'에서는 플래시 TTS(0.920점)와 플래시-라이트 TTS(0.914점)가 기존 모델들을 제치고 각각 1위와 2위에 올랐으며, '보이스 아레나(Voice Arena)'의 블라인드 선호도 평가에서도 일본어, 브라질 포르투갈어, 베트남어, 현대 표준 아랍어, 멕시코 스페인어, 힌디어 등 주요 언어에서 높은 순위를 기록했다.
안전장치도 적용됐다. 생성되는 모든 음성에는 식별 가능한 워터마크인 '신스ID(SynthID)'가 삽입된다. 구글은 이를 통해 AI 생성 음성을 명확히 식별하고 무단 도용 방지 안전장치를 결합했다고 밝혔다.
개발자들은 구글 AI 스튜디오와 제미나이 API를 통해 두 모델을 바로 이용할 수 있다. 일반 사용자와 기업의 경우 '제미나이 노트북(Gemini Notebook)'에는 플래시 TTS가, '구글 비즈(Google Vids)'에는 플래시-라이트 TTS가 탑재돼 제공된다.
박찬 기자 cpark@aitimes.com