아래는 출처에서 가져온 원문입니다.
오픈AI가 단순한 최고 성능 경쟁에서 벗어나 실무에 필요한 핵심 기능의 효율성을 극대화한 'GPT-6 솔(Sol)'과 'GPT-6 루나(Luna)'를 공개하며 API 이용료를 기존 대비 절반 이하로 내렸다.
22일(현지시간) 출시된 GPT-6 솔과 루나는 최첨단 모델의 대중화를 목표로 비용 효율성을 극대화한 것이 핵심이다.
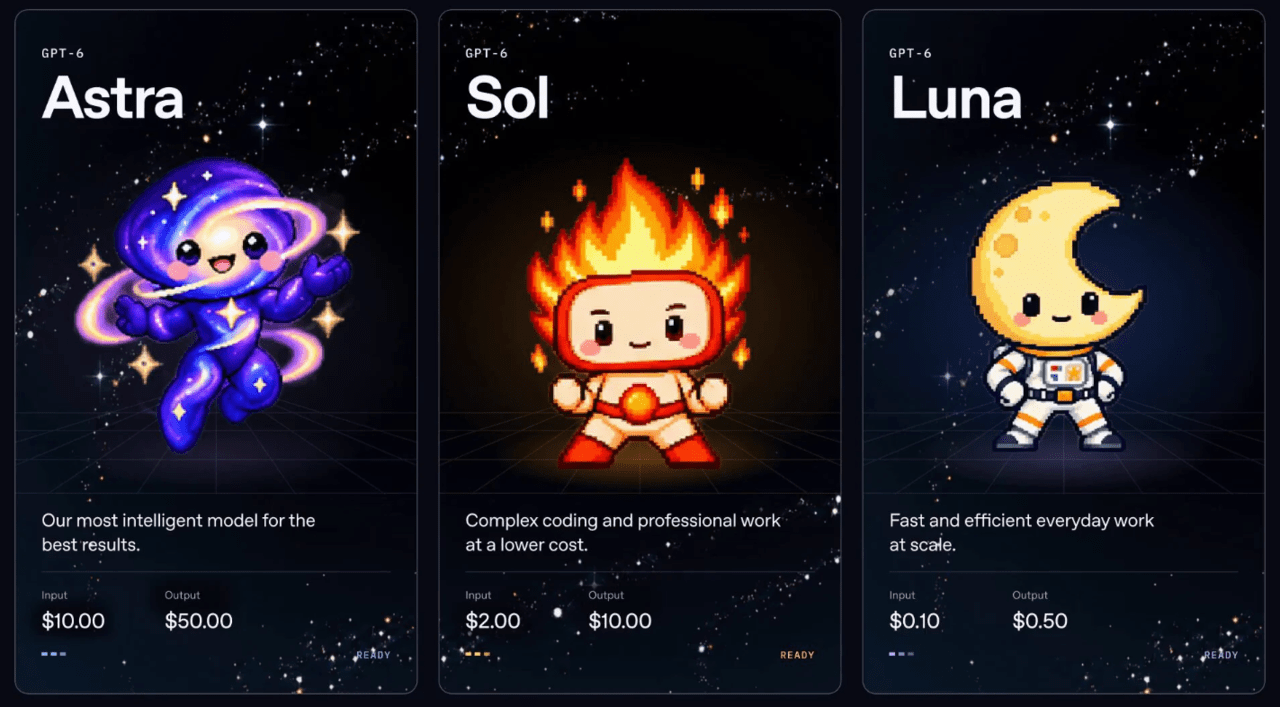
오픈AI는 기존 'GPT-5.6' 프로모션 가격 대비 API 비용을 50% 인하했다. 이에 따라 GPT-6 솔의 API 가격은 100만 토큰당 입력 2달러·출력 10달러, GPT-6 루나는 입력 0.10달러·출력 0.50달러로 크게 낮아졌다. 오픈AI는 "이번 가격은 일시적인 할인 프로모션이 아닌 정식 확정 가격"이라고 설명했다.
전문가들도 가격 정책과 시장 구도 변화에 집중했다. GPT-6 솔의 가격인 입력 2달러·출력 10달러는 앤트로픽의 '클로드 소네트 5'와 일치하며, 앤트로픽이 같은 날 발표한 '클로드 오퍼스 5.5(입력 4달러·출력 20달러)'보다 50% 저렴하다. AI 시장의 경쟁 중심이 프런티어 최고 성능 경쟁에서 대규모 실무 작업의 경제성 확보로 빠르게 중심을 이동하고 있다는 평이다.
GPT-6 Sol and Luna push the cost efficiency frontier by halving cost relative to GPT-5.6 Sol and Luna. Intelligence Index and Coding Agent Index scores remain level with GPT-5.6, with progress in some evaluations and regressions in others
Pricing is approximately half that of… pic.twitter.com/eubnxPVsyN
— Artificial Analysis (@ArtificialAnlys) September 22, 2026
아티피셜 애널리시스(AA)의 지능 지수에서는 48점을 기록, GPT-6 아스트라(53점)보다 낮은 전체 6위를 기록했다. 그러나 AA는 "이번 출시의 핵심은 새로운 최고 성능 기록 달성이 아니라, 기존 플래그십 수준의 성능을 파격적인 수준의 비용 절감과 함께 제공한다는 점"이라며 "AI 모델 시장의 경쟁 축이 단위당 가성비와 비용 효율성으로 이동하고 있음을 보여준다"라고 분석했다.
그러나 비용 절감을 위해 일부 복잡한 장기 지식 작업이나 전문 문서 작성 등의 영역에서는 이전 세대나 플래그십 모델 대비 점수 하락 현상도 관측됐다.
아티피셜 애널리시스(AA)에 따르면, 전문 직무 역량을 다루는 'GDPval-AA v2.1'에서 GPT-6 솔은 49%를 기록해 클로드 오퍼스 5.5(67%)와 GPT-6 아스트라(52%)에 못 미쳤다. 터미널 제어 성능인 '터미널벤치 4.0'에서도 44%에 그치며 오퍼스 5.5(60%) 및 아스트라(59%)와 격차를 보였다.
지식 정확도(AA-Omniscience Accuracy) 역시 54%로 낮아졌는데, 이는 환각을 줄이기 위해 확실하지 않은 질문에 답변을 거부하는 비중을 늘렸기 때문으로 풀이된다. 그럼에도 태스크당 수행 비용은 1.06달러 수준으로 경쟁 모델 대비 파격적으로 낮아 '비용 대비 성능'의 우위는 유지했다.
이처럼 모든 영역의 지표를 올리기보다, 개발자와 기업들이 가장 필요로 하는 코딩과 업무 자동화 등 핵심 실무 영역에 집중해 효율을 극대화한 정황이 확인됐다.
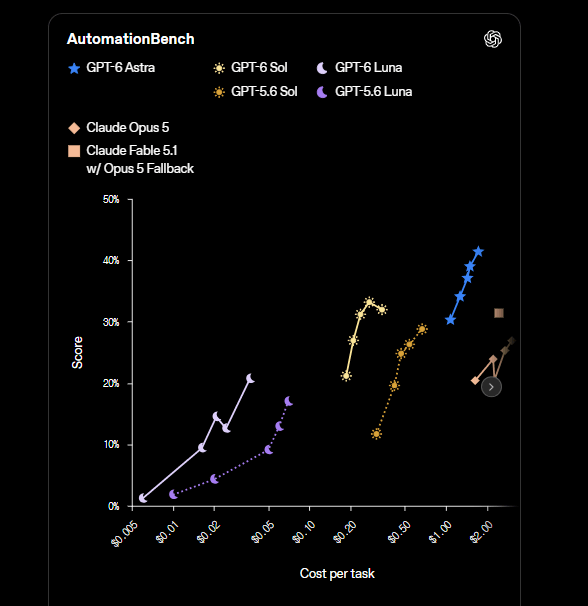
실제로 업무 자동화 워크플로우 평가인 '오토메이션벤치'에서 가장 높은 추론 노력(xhigh) 설정 시 작업당 비용이 클로드 오퍼스 5의 9% 수준인 0.27달러에 불과함에도 이를 뛰어넘는 성과를 기록했다. 클로드 오퍼스 5 대비 11.1배, 클로드 페이블 5.1 대비 8.9배 이상 저렴한 셈이다.
전문 직무 역량을 검증하는 '에이전트의 마지막 시험(Agents' Last Exam)' 평가에서도 최고 노력 설정 시 56.4%를 받아 클로드 오퍼스 5의 최고 점수를 넘어서며 작업당 비용은 60% 절감했다.
코딩 역량도 대폭 향상됐다. 실제 프로젝트 환경을 평가하는 '딥SWE v1.1' 테스트에서 최대 노력 설정 시 68.8%의 점수를 받아 페이블 5 최고 점수인 69.9%에 바짝 다가섰으며, 작업당 비용은 80%가량 절감했다. 경량화 모델인 GPT-6 루나도 66.6%를 기록하며 클로드 오퍼스 5 및 페이블 5의 중간 노력 설정 성과와 대등한 수준을 보였으나, 비용은 오퍼스 5 대비 93%, 페이블 5 대비 96%나 저렴했다.
컴퓨터 제어 능력을 측정하는 'OS월드 2.0' 평가에서도 오퍼스 5와 유사한 60.5%의 점수를 달성하면서 비용을 80% 줄였고, GPT-6 루나는 이전 세대 중간 모델보다 10분의 1 비용으로 뛰어난 성과를 냈다.
환각 현상도 크게 줄였다. 사용자 피드백 기반 내부 사실성 평가 결과, GPT-6 솔은 이전 세대 대비 오류 발생 비율을 절반으로 줄여 플래그십인 아스트라 수준에 근접했으며, GPT-6 루나는 높은 추론 노력 설정 시 이전 세대 솔 모델의 성능을 100분의 1 수준의 비용으로 구현했다.
개발자 커뮤니티에서는 실제 체감 성능에 대한 활발한 토론이 벌어졌다. 개발자들은 "상위 벤치마크 최고 점수를 경신한 것은 아니지만 API 수수료 부담 없이 실무 개발 코딩과 에이전트 반복 작업을 돌릴 수 있게 된 점이 실질적인 대형 호재"라며 저렴해진 가격 체계를 긍정적으로 평가했다. 특히 코덱스 환경에서 작업을 수행할 때 작업 연속성과 응답 속도가 눈에 띄게 좋아졌다는 평가가 잇따랐다.
다만 일부 개발자들 사이에서는 "기존 모델 특유의 과도하고 불필요한 보일러플레이트 코드나 테스트 케이스 생성 경향이 얼마나 정제되었는지는 실무 대규모 코드베이스에 더 적용해 봐야 알 수 있을 것"이라는 반응도 이어졌다.
오픈AI는 "단순히 토큰 가격을 내리는 것에 그치지 않고, 캐싱 기능 및 추론 효율성 개선을 지속하여 대규모 업무와 장시간 에이전트 대화에서 발생하는 비용 부담을 근본적으로 낮췄다"라며 "프롬프트 캐싱 개선을 통해 응답 속도를 높이고 재사용 토큰에 대해 90%의 할인 혜택을 제공한다"라고 설명했다.
GPT-6 솔과 루나는 챗GPT 플러스, 프로, 비즈니스, 엔터프라이즈, 에듀 등 유료 요금제 사용자의 '챗GPT 워크'와 '코덱스' 환경에 적용되며, 데스크톱 앱을 통해 일반 무료 사용자에게도 루나 모델이 제공된다. API 플랫폼에서는 'gpt-6-sol' 및 'gpt-6-luna'라는 모델명으로 이용할 수 있다.
한편, 이번 출시는 샘 알트먼 오픈AI CEO가 사전 예고했던 연속 발표의 시작이다. 오픈AI는 오는 29일 열리는 '데브데이 2026'에서 추가 발표를 이어갈 예정이다. 업계는 실시간 차세대 에이전트 프레임워크와 오토노머스 워크플로우 도구, 확장된 음성·비전 멀티모달 API 등 개발자 생태계를 겨냥한 제품이 공개될 것으로 전망하고 있다.
임대준 기자 ydj@aitimes.com